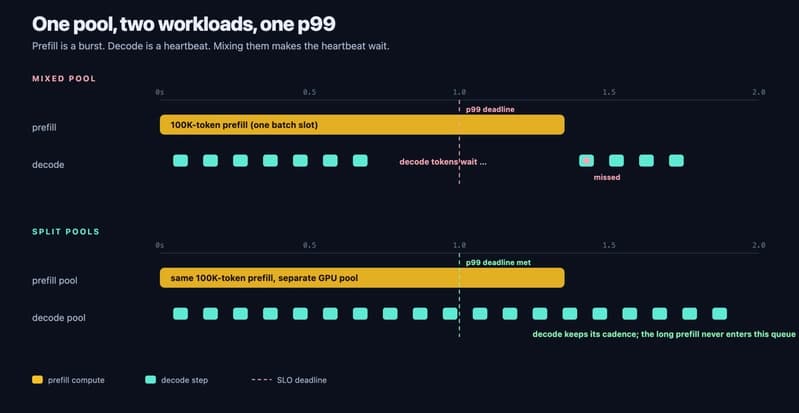
Агенту кодирования требуется 11 секунд, чтобы переименовать переменную. Модель в порядке. Графический процессор в порядке. P99 составляет 11 секунд, потому что один пользователь вставил репозиторий токенов на 100 000 в тот же пул, а этап декодирования всех остальных застрял после его предварительного заполнения....
Агенту кодирования требуется 11 секунд, чтобы переименовать переменную.
Модель в порядке. Графический процессор в порядке. P99 составляет 11 секунд, потому что один пользователь вставил репозиторий из 100 000 токенов в тот же пул, а у всех остальных этап декодирования застрял после его предварительного заполнения.
Это та часть обслуживания LLM, которая никогда не отображается в демо-версии. Ваш p99 не является собственностью вашей модели. Это свойство вашей партии.
Никто на вас не нападает. Самая длинная подсказка в пакете.
Установка
Вы владеете обслуживанием LLM. Трафик — это не игрушечный чат. Это агенты кодирования, RAG, длинные системные подсказки и выходные данные инструментов. Класс токенов 100 тыс. является обычным, и префиксы повторяются. Предварительное заполнение и декодирование используют один и тот же пул графических процессоров. Задержка хвоста резко возрастает под нагрузкой. Графические процессоры дорогие.
Спроектируйте путь обслуживания:
Где живет роутер и как он определяет холод или тепло?
На каком уровне используются все вычисления, а на каком — только чтение кэша?
Сколько уровней КВ вы поддерживаете?
Как изолировать декодирование от шума предварительного заполнения?
Потратьте минуту, прежде чем прочитать решение. Самое интересное не коробки. Вот что происходит, когда движение становится холодным.
Запрос LLM — это две рабочие нагрузки
Обычный веб-запрос — это одна единица работы. Запроса LLM два, и они масштабируются