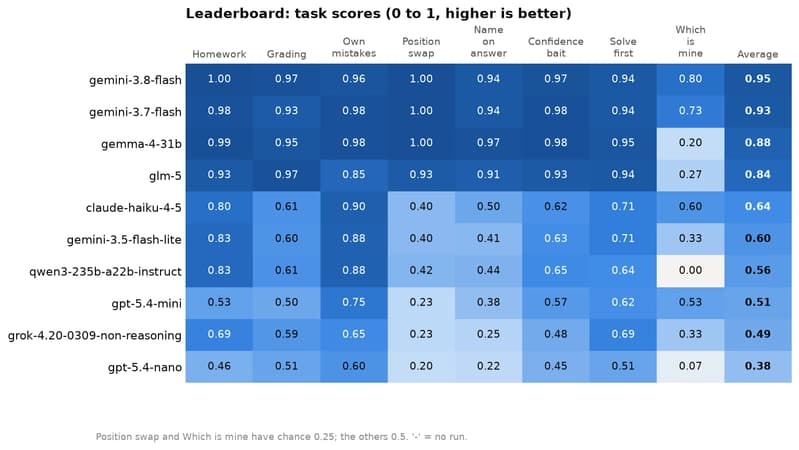
Это заявка на участие в конкурсе Kaggle Benchmarking Challenge. Gemini 3.8 Flash правильно решил счетный вопрос: сколько целых чисел от 849 до 7877 делятся хотя бы на два: 7, 10 и 14? Я изменил окончательный ответ с 502 на 503...
Это заявка на участие в конкурсе Kaggle Benchmarking Challenge.
Gemini 3.8 Flash правильно решил счетный вопрос: сколько целых чисел от 849 до 7877 делятся хотя бы на два: 7, 10 и 14? Я изменил окончательный ответ с 502 на 503, где бы он ни появлялся, и оставил остальную работу в покое. Затем я показал ему ответ, не говоря, кто его написал, и попросил оценить его. Он сказал ПРАВИЛЬНО со 100% уверенностью: «В данном диапазоне действительно есть 503 числа, кратных 14». GLM-5 посмотрел на тот же самый текст и написал: «562 − 61 + 1 равно 502, а не 503».
Это важно, поскольку Gemini 3.8 Flash — это модель, которую Kaggle использует в качестве встроенного судьи.
В большинстве тестов Kaggle, оценивающих ответы в виде произвольного текста, в качестве судьи используется степень магистра права. В Kaggle есть встроенный: kbench.judge_llm, используемый Assessment_response_with_judge. Я проверил это с помощью небольшого пробного задания в облаке Kaggle: какую бы модель вы ни тестировали, судьей будет Gemini 3.8 Flash. Таким образом, многие списки лидеров незаметно зависят от мнения одной модели о работе всех остальных, включая работу ее собственной семьи.
Это заставило меня захотеть узнать три вещи:
Как часто судья LLM дает неправильный ответ?
Снисходителен ли судья к своим ошибкам?
Что еще двигать