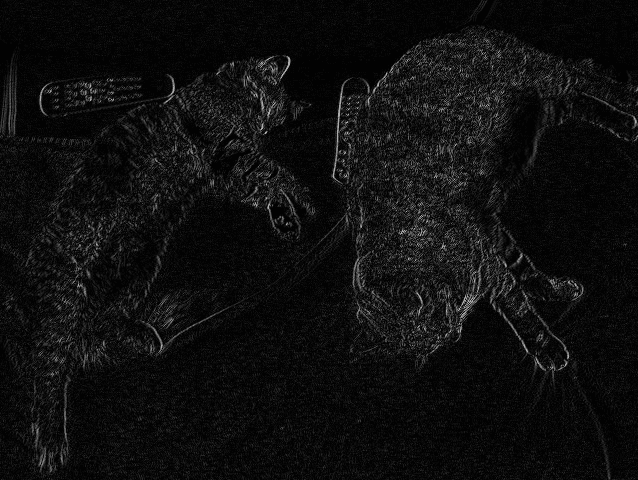
Я хотел понять модели языка видения (VLM), ИИ, который смотрит на фотографию и отвечает на вопросы о ней. Итак, я начал с крошечной сетки чисел и закончил тем, что задал ИИ вопрос о двух спящих кошках. Все, что ниже, работает бесплатно в ...
Я хотел понять модели языка видения (VLM), ИИ, который смотрит на фотографию и отвечает на вопросы о ней. Итак, я начал с крошечной сетки чисел и закончил тем, что задал ИИ вопрос о двух спящих кошках.
Все, что указано ниже, работает бесплатно в Google Colab.
Изображение — это просто цифры
импортировать numpy как np
крошечный = np.zeros((8, 8))
tiny[:, 4:] = 9 # слева темный, справа яркий
печать (крошечная)
Выход:
[[0. 0. 0. 0. 9. 9. 9. 9.]
[0. 0. 0. 0. 9. 9. 9. 9.]
[0. 0. 0. 0. 9. 9. 9. 9.]
[0. 0. 0. 0. 9. 9. 9. 9.]
[0. 0. 0. 0. 9. 9. 9. 9.]
[0. 0. 0. 0. 9. 9. 9. 9.]
[0. 0. 0. 0. 9. 9. 9. 9.]
[0. 0. 0. 0. 9. 9. 9. 9.]]
Каждая строка равна 0 0 0 0 9 9 9 9. Ребро есть, но компьютеру нужен способ его найти.
Фильтр находит край
kernel = np.array([-1, 0, 1]) # правый пиксель минус левый пиксель
out = np.array([[np.sum(tiny[r, c:c+3] * kernel) для c в диапазоне (6)] для r в диапазоне (8)])
распечатать (вывести)
Выход:
[[0. 0. 9. 9. 0. 0.]
[0. 0. 9. 9. 0. 0.]
[0. 0. 9. 9. 0. 0.]
[0. 0. 9. 9. 0. 0.]
[0. 0. 9. 9. 0. 0.]
[0. 0. 9. 9. 0. 0.]
[0. 0. 9. 9. 0. 0.]
[0. 0. 9. 9. 0. 0.]]
Каждая строка становится 0 0 9 9 0 0. Плоские области дают 0, а загорается только край.
Тот же фильтр на реальной фотографии
запросы на импорт
от ПИ