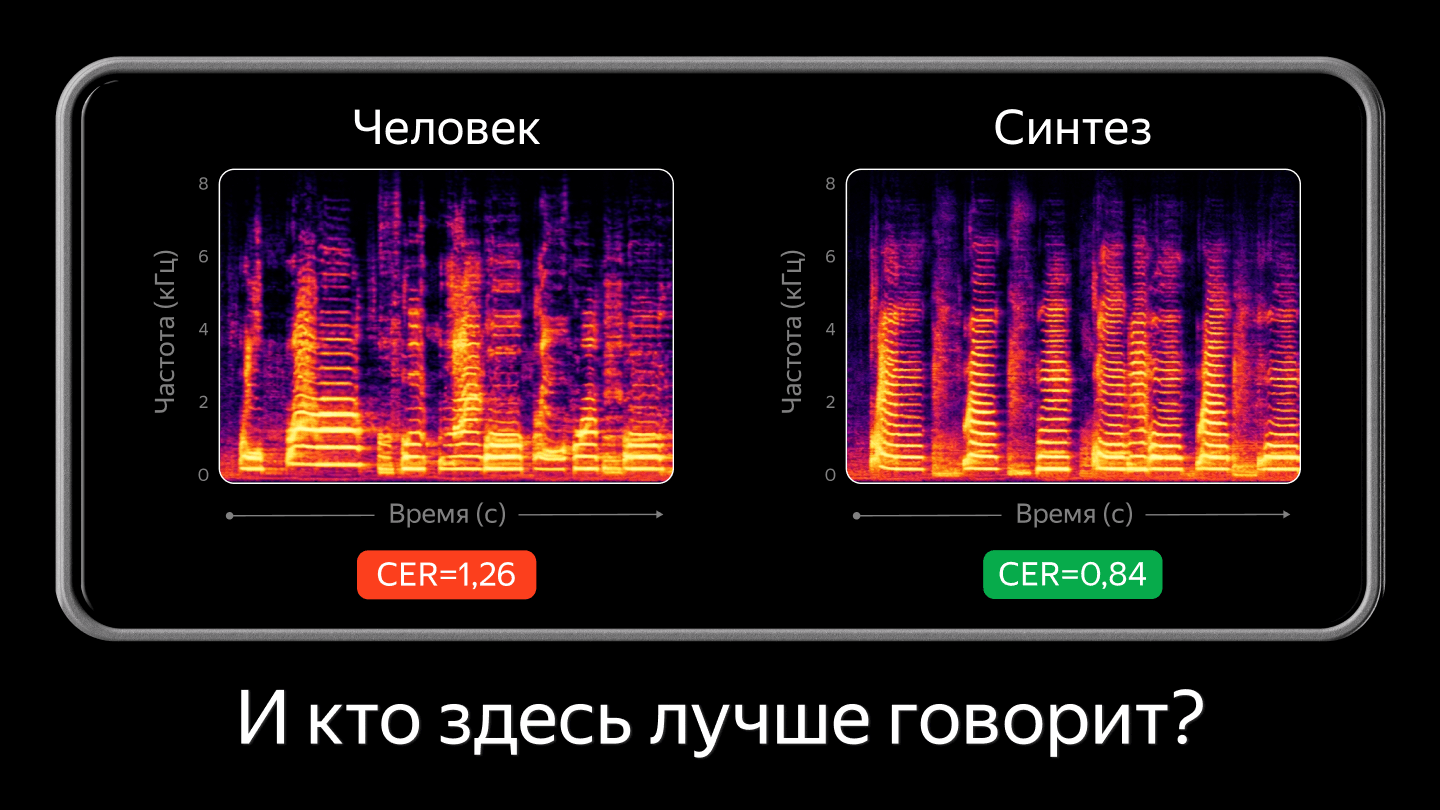
Привет, Хабр! Меня зовут Саша, я пишу курс «Аудиоанализ, распознавание и генерация речи» в Яндекс Практикуме, работаю ML-инженером в аудиодомене и вообще послеживаю за индустрией. Пару месяцев назад вышла статья по генерации речи от Alibaba...
Привет, Хабр! Меня зовут Саша, я пишу курс «Аудиоанализ, распознавание и генерация речи» в Яндекс Практикуме, работаю ML-инженером в аудиодомене и вообще послеживаю за индустрией.
Пару месяцев назад вышла статья по генерации речи от Alibaba — Qwen-Audio-3.0-TTS. И вот что примечательно: в таблице результатов на SEED-TTS-Eval есть строка Human, и это не какая-то модель-гуманоид, а настоящая живая человеческая речь, прогнанная через тот же бенчмарк, что и все системы в сравнении. Так сказать, контрольная точка отсчёта.
Так вот, у человека там ошибка 1,26, а у модели, про которую эта статья, — 0,84. На этой строчке я застрял и сел делать разбор, потому что за ней, возможно, стоит проблема поинтереснее самой модели. Вечная проблема метрик.
Под катом попробуем разобраться, что у них там происходит.