Последние пару лет мы довольно странно используем большие языковые модели. Из-за их умения делать всё мы пытаемся решить с их помощью всё — роутинг запросов, модерацию, оценку и многое другое. При этом такой сетап инженерно некрасивый: у на...
Последние пару лет мы довольно странно используем большие языковые модели.
Из-за их умения делать всё мы пытаемся решить с их помощью всё — роутинг запросов, модерацию, оценку и многое другое. При этом такой сетап инженерно некрасивый: у нас есть модели, которые умеют вести диалог, хорошо программировать и писать статьи, но немалую часть времени инференса они тратят на ответы на достаточно простые вопросы с двумя-тремя вариантами ответов.
Это работает. Но выглядит как доставка упаковки сырников на завтрак на огромной фуре, а альтернатива — обучать отдельную модель под каждую задачу. В сентябре 2026 года вокруг этой проблемы сформировался отдельный класс моделей — Decision Models. 15 сентября TypeSafe показали Jev, а дальше модели принятия решений полетели со всех сторон.
Мне ооочень нравится этот класс моделей, и потому возник простой вопрос: а насколько хорошо это работает в реальной жизни и можно ли тащить это в прод?
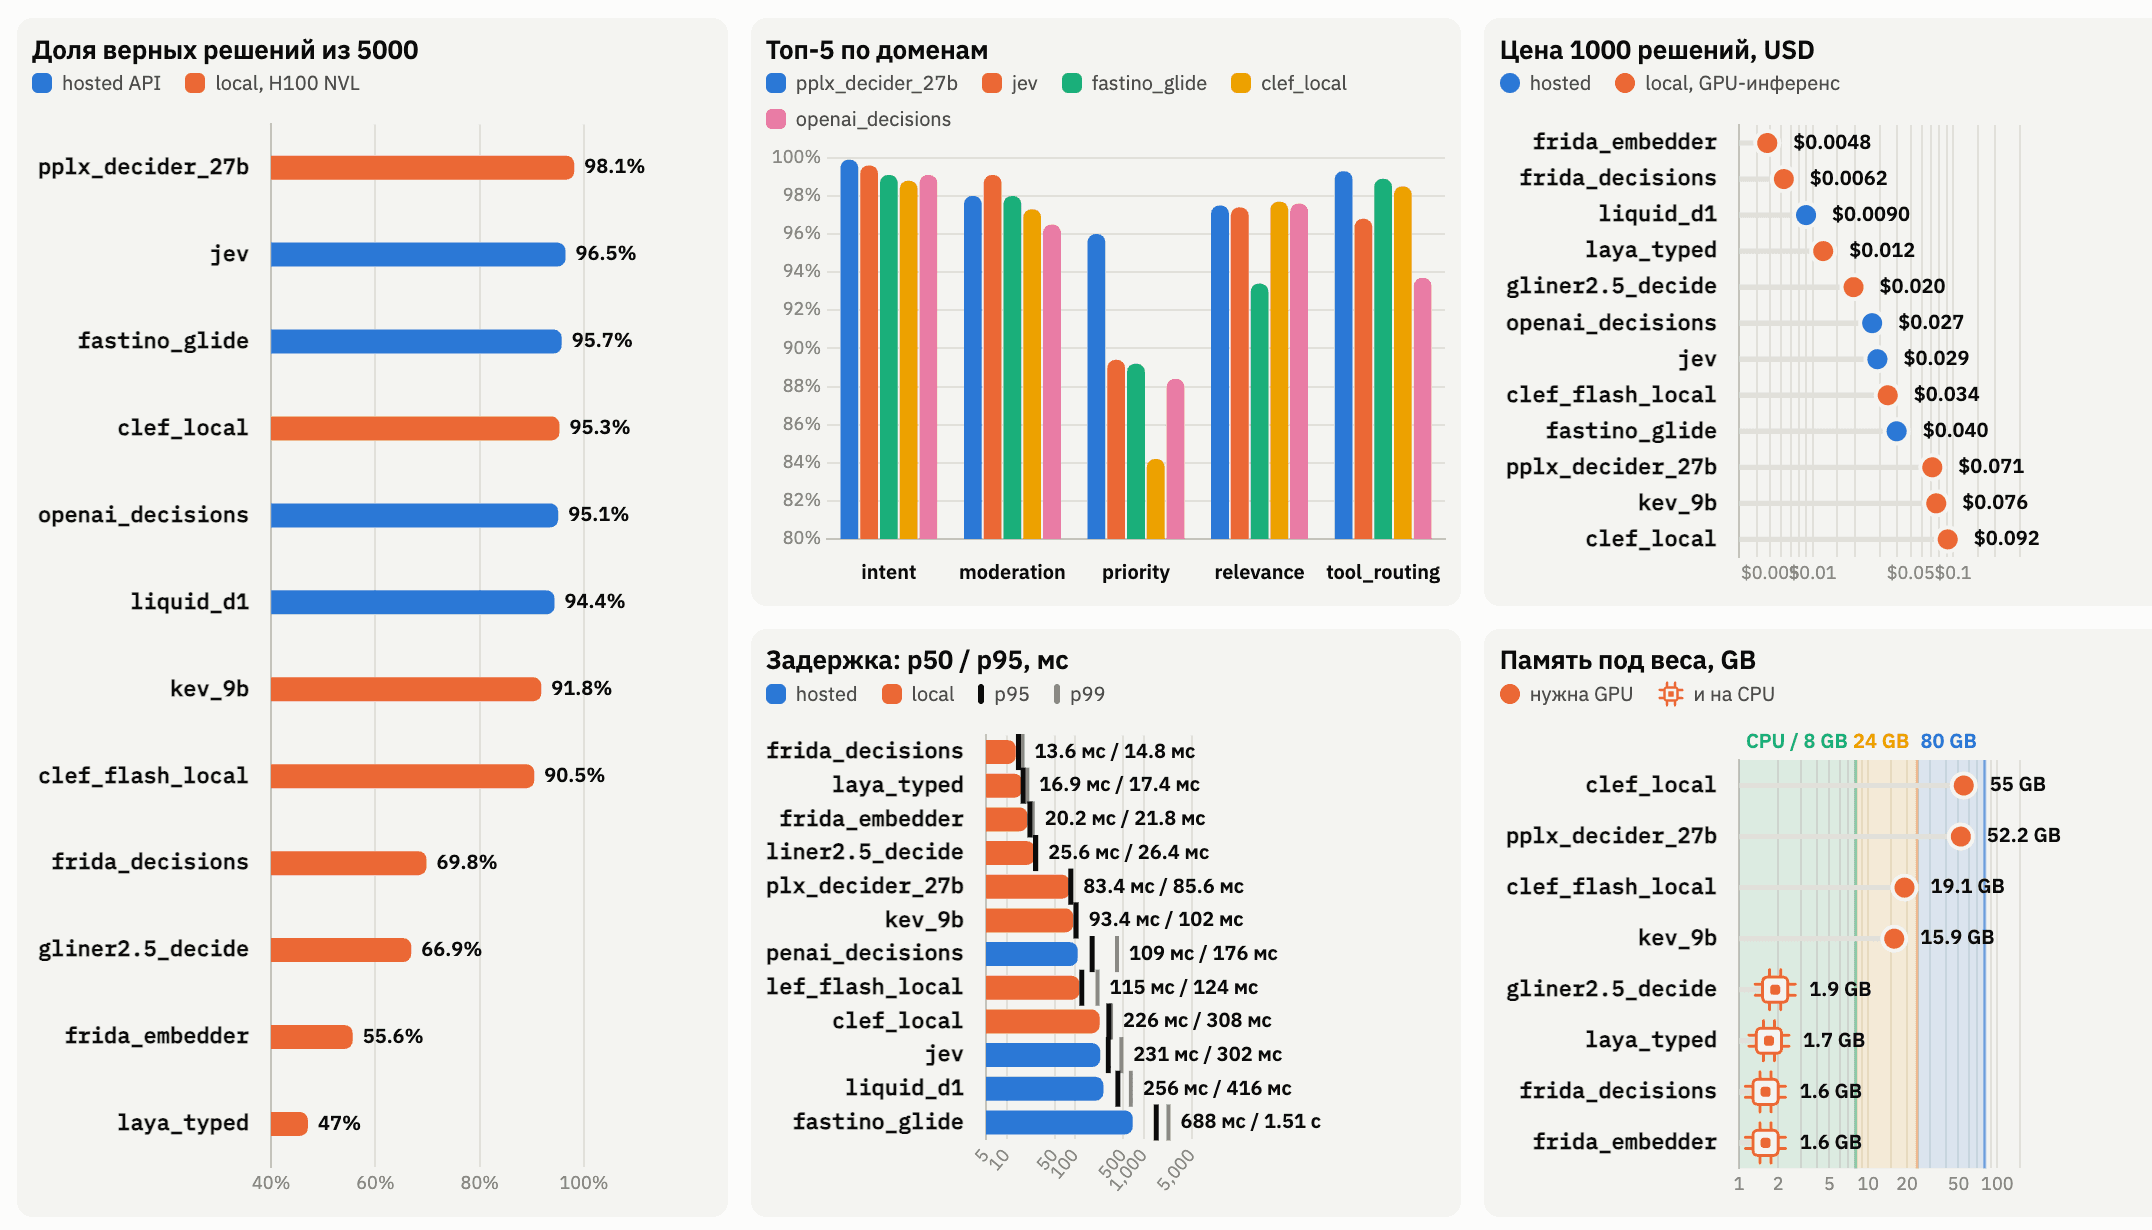
Чтобы ответить на этот вопрос, я сконструировал бенчмарк для сравнения качества, скорости и стоимости принятия решений. Будем тестировать и облачные, и self-hosted модели: Perplexity Decider 27B, TypeSafe Jev, Fastino GLiDE и GLiNER2.5-Decide, Cloudflare Clef 27B, OpenAI GPT-6 Luna Decisions, Liquid d1, Kev-9B, Cloudflare Clef-flash 9B, FRIDA-Decisions (и FRIDA Embedder) и Laya Typed Decisions.
Погнали!