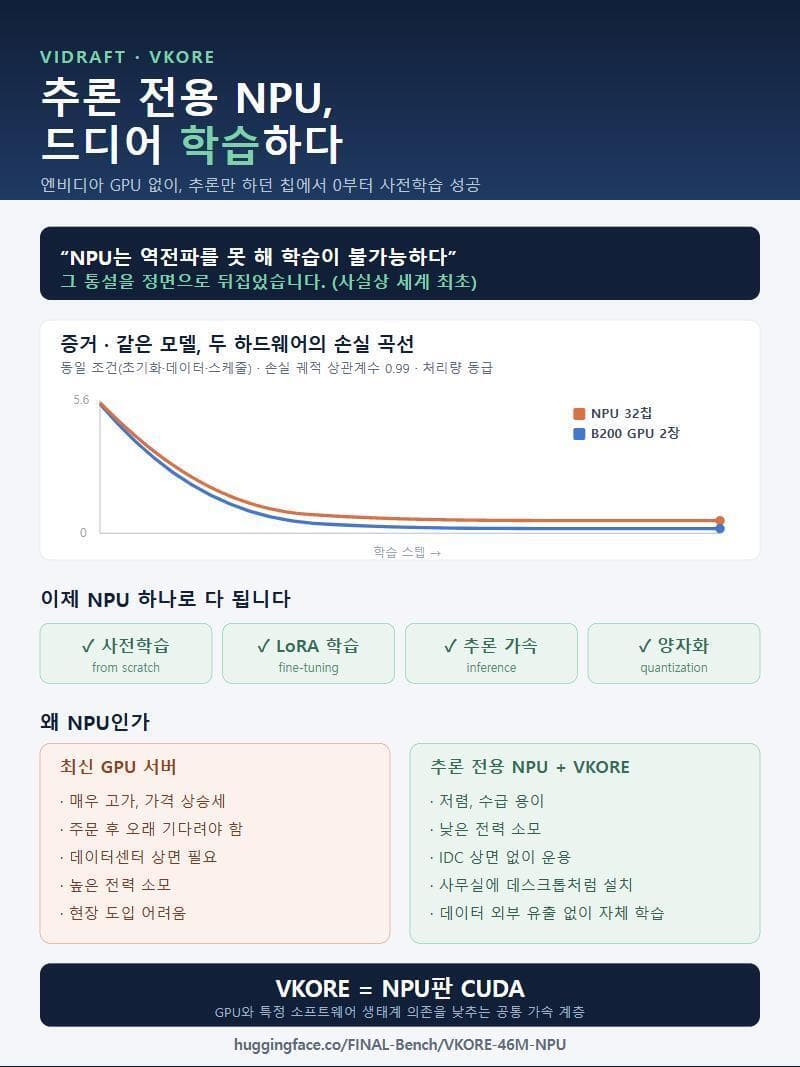
Резюме (TL;DR): BDraft удалось предварительно обучить небольшую языковую модель с нуля, используя только NPU, предназначенный только для вывода, и выпустил полученный VKORE-46M-NPU вместе с моделью, карточкой модели и сравнительными данными на Hugging Face. Фактически это первый в мире случай в публичной литературе, который напрямую опровергает распространенное мнение о том, что «NPU, предназначенный только для вывода, не может осуществлять обратное распространение ошибки и, следовательно, его невозможно изучить». Результат обучения той же модели в тех же условиях на графическом процессоре и коэффициент корреляции траектории потерь достиг 0,99...
Резюме (TL;DR): BDraft удалось предварительно обучить небольшую языковую модель с нуля, используя только NPU, предназначенный только для вывода, и выпустил полученный VKORE-46M-NPU вместе с моделью, карточкой модели и сравнительными данными на Hugging Face. Фактически это первый в мире случай в публичной литературе, который напрямую опровергает распространенное мнение о том, что «NPU, предназначенный только для вывода, не может осуществлять обратное распространение ошибки и, следовательно, его невозможно изучить». Коэффициент корреляции между траекторией потерь и результатом обучения той же модели в тех же условиях на GPU достиг 0,99.
Почему «обучение на NPU только для вывода» — это вещь
NPU, предназначенный только для вывода, предназначен для прямого вывода. Обучение требует обратного распространения ошибки, состояния оптимизатора и многочиповой синхронизации — путей, которые обычно отсутствуют в стеке вывода. Поэтому в отрасли широко распространено мнение, что точная настройка LoRA, а также предварительное обучение структурно невозможны. BDraft выполняет обратное распространение ошибки непосредственно на чипе, предназначенном только для вывода, обучая модель с нуля без предварительно обученных весов.
Доказательства: кривые потерь для одной и той же модели, двух аппаратных средств.
Самая надежная часть — метод проверки. Та же модель была обучена с 0 на чипе NPU 32 и графическом процессоре с той же инициализацией, данными и графиком и сравнена.
Коэффициент корреляции траекторий потерь двух обучений: 0,99.
Пропускная способность (ток/с) также сходится к одному и тому же уровню.
Одна фотография, показывающая потерю, не является доказательством. Когда ядро низкой точности измельчает градиент, оно рисует траекторию, отличную от траектории графического процессора. Тот факт, что эталонные кривые графического процессора и кривые потерь перекрываются на 0,99 при одних и тех же условиях, является убедительным доказательством того, что обратное распространение ошибки и обновление оптимизатора численно делают практически то же самое, что и эталон.
Это работало и на старых чипах.
Это достижение было достигнуто не с помощью новейшего чипа, а с помощью NPU первого поколения (32 чипа), выпущенного в 2025 году. Как это было возможно со старым оборудованием, в NPU следующего поколения есть значительные возможности для улучшения производительности.
Теперь все это делается с помощью всего лишь одного NPU
Предварительное обучение (с нуля)
Тонкая настройка LoRA
Ускорение вывода (также подтверждено, что оно применимо к общедоступным моделям общего назначения)
Модель квантования вождения/ускорения
Bdraft интегрирует эту технологию в программный уровень, специфичный для NPU, под названием «VKORE». Подобно тому, как NVIDIA установила доминирование благодаря экосистеме программного обеспечения под названием CUDA, а не аппаратному обеспечению графического процессора, VKORE представляет собой «версию CUDA для NPU», нацеленную на ту же основу в NPU. Это общий уровень ускорения, который снижает зависимость от конкретного графического процессора и его программной экосистемы.
почему это важно