Заметки полного разработчика, изучающего генеративный искусственный интеллект. В последнее время я уделяю некоторое время изучению прикладного искусственного интеллекта и генеративного искусственного интеллекта. Имея опыт комплексной веб-разработки, я изначально думал о создании приложения на базе искусственного интеллекта...
Заметки полного разработчика, изучающего генеративный искусственный интеллект.
В последнее время я уделяю некоторое время изучению прикладного искусственного интеллекта и генеративного искусственного интеллекта.
Имея опыт комплексной веб-разработки, я изначально думал, что создание приложений на базе искусственного интеллекта не будет сильно отличаться от интеграции любого другого API.
Вы отправляете запрос, модель обрабатывает входные данные, и вы получаете ответ.
И технически это правда.
Но чем больше я узнаю о том, как работают модели большого языка (LLM), тем больше понимаю, что многое происходит за кулисами, прежде чем модель сгенерирует ответ.
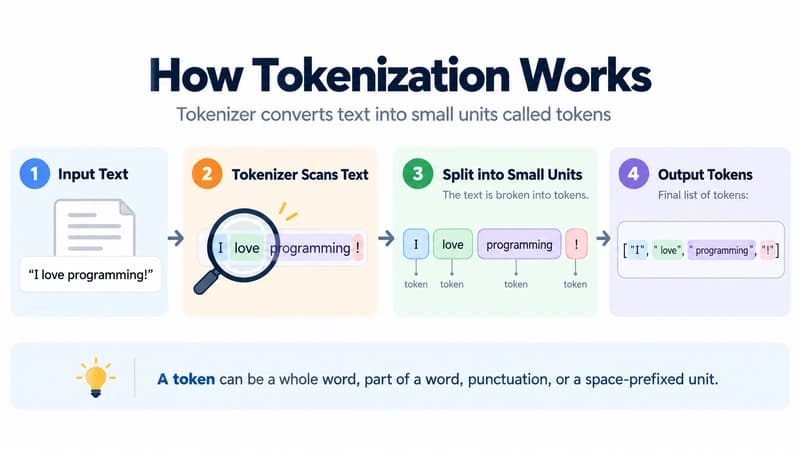
Одной из первых концепций, которая привлекла мое внимание, была токенизация.
На первый взгляд это звучит довольно просто. Но, как оказалось, токенизация играет важную роль в том, как языковые модели обрабатывают текст, обрабатывают контекст и даже в том, сколько стоит их использование.
ИИ не читает предложения, как люди
Когда мы читаем такое предложение:
В настоящее время я изучаю генеративный искусственный интеллект.
Наш мозг естественным образом распознает слова и понимает смысл предложения.
Но LLM не обрабатывает необработанный текст таким же образом.
Прежде чем модель сможет работать с текстом, она проходит процесс, называемый токенизацией.