Предыдущая глава Ну а теперь рассмотрим, как нам применить обученный трансформер. И применение уже обученной модели сильно отличается от тренировки, потому что теперь приходится учитывать еще один фактор - задержку. Так что давайте разбират...
Предыдущая глава
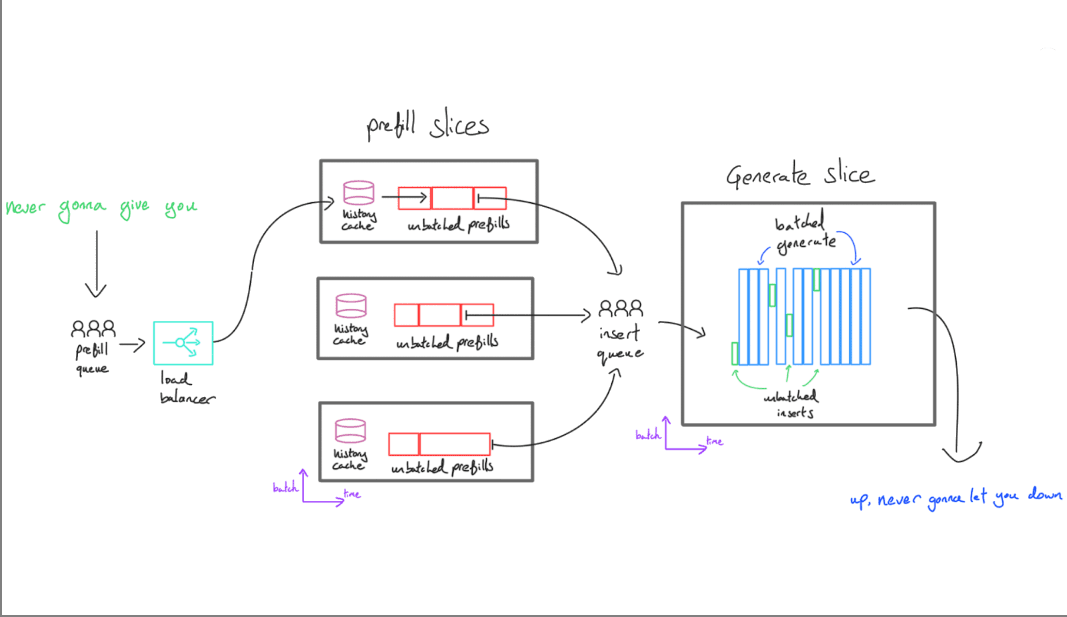
Ну а теперь рассмотрим, как нам применить обученный трансформер. И применение уже обученной модели сильно отличается от тренировки, потому что теперь приходится учитывать еще один фактор - задержку. Так что давайте разбираться, как устроен инференс LLM и как его правильно масштабировать.