В крупномасштабных службах вывода ИИ при масштабировании кластера вновь добавленные экземпляры вывода должны пройти ряд этапов холодного запуска, прежде чем они смогут обслуживать запросы: подготовка образа контейнера, монтирование файловой системы, среда выполнения и информация...
В крупномасштабных службах вывода ИИ при масштабировании кластера вновь добавленные экземпляры вывода должны пройти ряд этапов холодного запуска, прежде чем они смогут обслуживать запросы: подготовка образа контейнера, монтирование файловой системы, инициализация среды выполнения и среды вывода, а также загрузка веса модели. Поскольку размеры изображений и вес моделей продолжают расти, время, затрачиваемое на подготовку данных, становится все более значительным. Во время крупномасштабных событий масштабирования многие экземпляры запускаются одновременно, что еще больше увеличивает одновременную нагрузку на реестр, сеть и внутреннее хранилище.
Чтобы решить эти проблемы, отрасль разработала несколько стратегий оптимизации, включая уменьшение размера образа, использование P2P-распределения для снижения давления одновременного запроса и использование загрузки по требованию для сокращения передачи данных на критическом пути запуска.
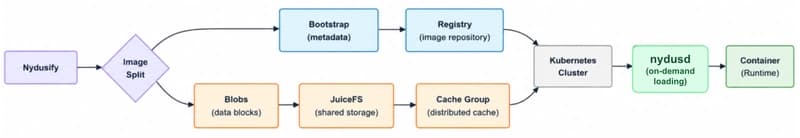
В этой статье мы рассмотрим подход, основанный на общем хранилище: объединение возможностей Nydus по загрузке изображений по требованию с механизмами распределенного хранения и кэширования JuiceFS. За счет совместного использования хранилища и повторного использования кэшированных данных этот подход уменьшает избыточное чтение данных во время крупномасштабного масштабирования и сокращает время запуска контейнера. Для сценария вывода ИИ