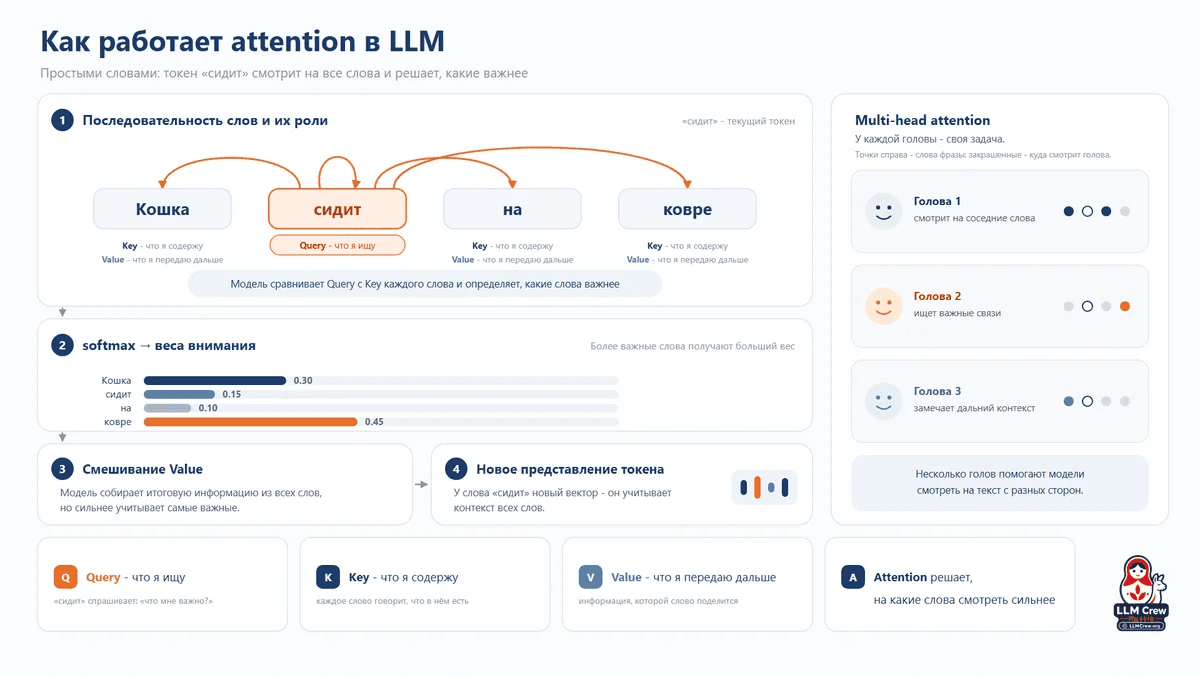
Почему современные LLM больше не используют один «обычный» Attention? Разбираем эволюцию механизмов внимания: MHA, GQA, MLA, local и sparse attention, linear/recurrent подходы и гибридные архитектуры вроде Qwen3.8 и DeepSeek. Смотрим, что п...
Почему современные LLM больше не используют один «обычный» Attention?
Разбираем эволюцию механизмов внимания: MHA, GQA, MLA, local и sparse attention, linear/recurrent подходы и гибридные архитектуры вроде Qwen3.8 и DeepSeek. Смотрим, что происходит с KV‑cache, почему длинный контекст так дорого обходится и как современные модели пытаются совместить качество retrieval с быстрым inference.