Опубликовано: 3 октября 2026 г. Что на самом деле представляет собой местный LLM Зачем запускать модель на своей машине Самый быстрый путь: Оллама в двух командах Цифры, которые я измерил на M5 на 16 ГБ 3B против 7B: какой выбрать? Действительно ли код, который он пишет...
Опубликовано: 3 октября 2026 г.
Оглавление
Что на самом деле представляет собой местный LLM
Зачем запускать модель на своей машине
Самый быстрый путь: Оллама в двух командах
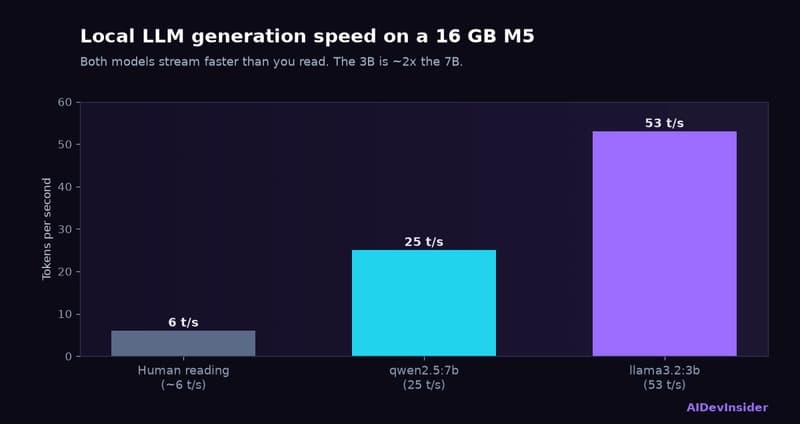
Цифры, которые я измерил на M5 на 16 ГБ
3B против 7B: какой выбрать?
Действительно ли код, который он пишет, работает?
В чем хорош местный LLM, а в чем нет
Следующими идут наблюдаемость и оценка.
Часто задаваемые вопросы
Локальный LLM — это языковая модель, которая полностью работает на вашем компьютере, без каких-либо вызовов API, покидающих компьютер. Я продолжал читать, что современный ноутбук теперь может с комфортом работать на нем, поэтому перестал гадать и измерил его. Я установил Ollama на Apple M5 с памятью 16 ГБ, извлек модель с 3 миллиардами параметров и модель с 7 миллиардами параметров и записал токены в секунду, использование памяти, время загрузки и действительно ли сгенерированный ими Python прошел тесты. Все, что приведено ниже, является реальным измерением этого сеанса, а не заявлением поставщика. Если вы решаете, стоит ли создавать местный LLM, вот как это выглядит на практике.
Краткая версия: 3B-модель генерировала текст со скоростью от 51 до 55 токенов в секунду, использовала 2,5 ГБ памяти и писала правильный, работоспособный код с первой попытки. Это быстрее, чем вы можете прочитать на уже имеющемся у вас оборудовании.
Что