mini-vllm-rs — это одноузловая система вывода LLM, которую я построил в Rust поверх Candle для macOS. Он может одновременно запускать серверные части CPU и Metal GPU, перенаправляя между ними целые запросы. Мой первый тест маршрутизации запросов предпочел отправить почти...
mini-vllm-rs — это одноузловая система вывода LLM, которую я построил в Rust поверх Candle для macOS. Он может одновременно запускать серверные части CPU и Metal GPU, перенаправляя между ними целые запросы. Мой первый тест маршрутизации запросов предпочитал отправлять почти все на графический процессор: самые быстрые политики назначили ему 11 из 12 запросов.
Это оставило без ответа более полезный вопрос: может ли выборочная разгрузка ЦП улучшить время завершения по сравнению с обслуживанием всей рабочей нагрузки только на графическом процессоре? Отделение предварительной заливки от декодирования подсказывало, где искать: запросы с теплыми префиксами, поступающие за растущим отставанием графических процессоров.
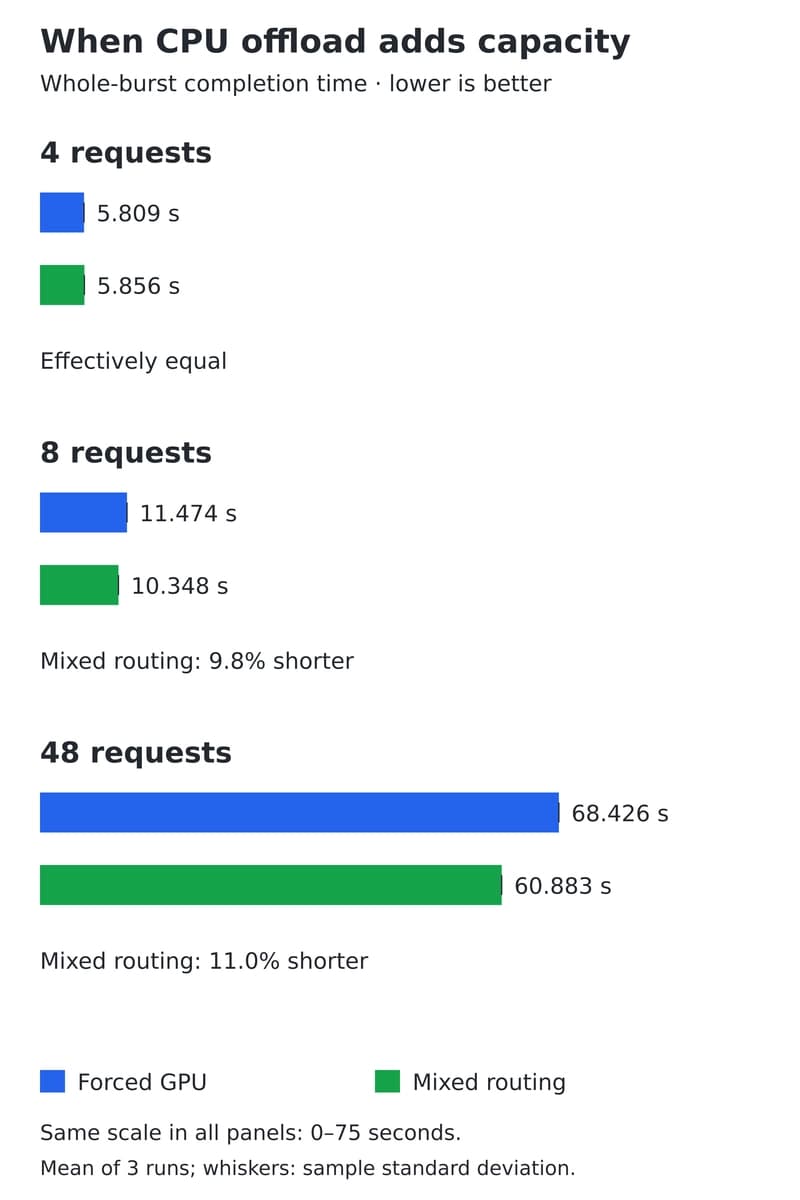
Последующий эксперимент проверил эту идею. Перенаправление 1 из 8 запросов на ЦП сократило время завершения пакета на 9,8% по сравнению с принудительной передачей всех 8 на ГП. При 48 запросах разгрузка 6 на ЦП увеличила совокупную выходную пропускную способность на 12,4%.
Фазовый разрыв подсказал следующий эксперимент
В экспериментах использовалась квантованная модель Qwen2.5 0,5B с активациями F32 на Apple M2. Для запроса с 512 входами и 128 выходами изолированные внутренние профили показали:
Фаза
ЦП
Металлический графический процессор
Преимущество графического процессора
Предварительное заполнение
73 ток/с
2551 ток/с
Около 35×
Декодировать
45 ток/с
293 ток/с
Около 6,5 ×
Длинная некэшированная подсказка раскрыла большие возможности процессора.