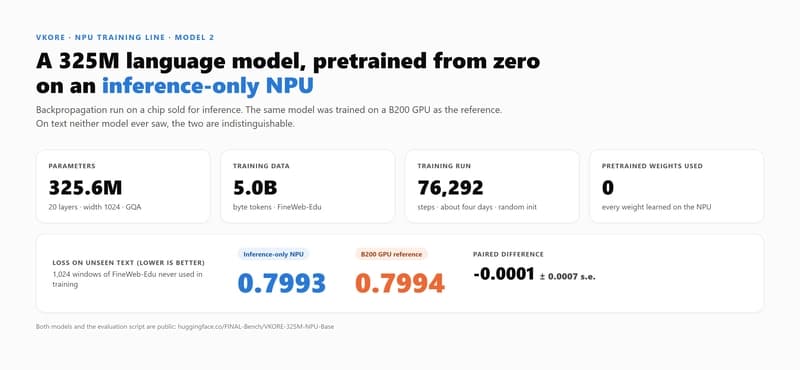
Раскрытие информации: приведенный ниже практический пример является собственным результатом VIDRAFT. ВИДРАФТ является технологическим партнером QuantID. В этом посте рассматривается схема измерения; это не независимая проверка. Чтобы заявить, что две тренировки достигли одинакового качества, вы...
Раскрытие информации: приведенный ниже практический пример является собственным результатом VIDRAFT. ВИДРАФТ является технологическим партнером QuantID. В этом посте рассматривается схема измерения; это не независимая проверка.
ТЛ;ДР
Чтобы утверждать, что два тренировочных прогона достигли одинакового качества, вам нужны две вещи: оценочный набор, который модели никогда не видели, и парное сравнение на идентичных входных данных. В данном случае речь идет о VKORE-325M от VIDRAFT, предварительно обученном на NPU Rebellions ATOM-Max и, для примера, на графическом процессоре B200. На 1024 невидимых окнах потери составляют 0,7993 и 0,7994; парная разница равна -0,0001 со стандартной ошибкой 0,0007.
Что делает сравнение двух прогонов справедливым?
Держите все фиксированным, кроме тестируемой переменной. В этом случае модель, инициализация, данные, пакетный график и график скорости обучения были идентичны, и отличалось только аппаратное обеспечение.
Соответствие кривых обучения обнадеживает, но не является доказательством. Потери при обучении измеряются на данных, которым соответствует модель.
Действительно ли «выдерживается»?
Этот случай содержит полезный урок. В первой оценке использовалось 256 фиксированных окон с конца обучающего файла, и она называлась «выдержанной». Но при обучении выбираются случайные окна из всего файла, через него проходит около 0,72, поэтому