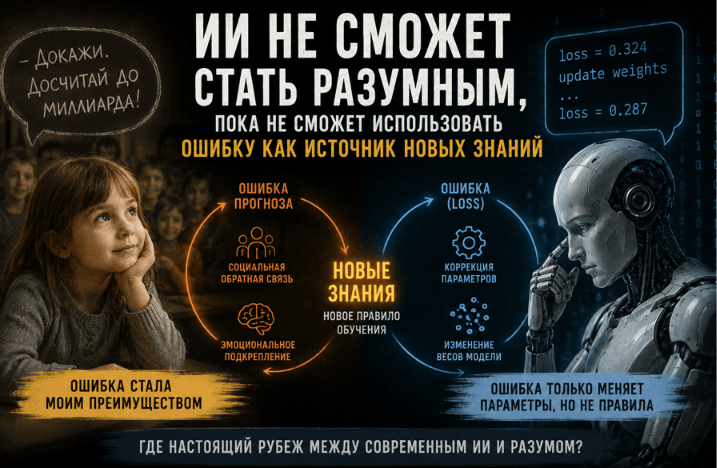
ИИ исправляет ошибку, а человек вписывает ее в свой опыт и что это говорит об ограничениях современных ИИ Современные ИИ используют разные формы обратной связи: функцию потерь (loss), вознаграждение и ошибку предсказания вознаграждения (re...
ИИ исправляет ошибку, а человек вписывает ее в свой опыт и что это говорит об ограничениях современных ИИ
Современные ИИ используют разные формы обратной связи: функцию потерь (loss), вознаграждение и ошибку предсказания вознаграждения (reward prediction error) в обучении с подкреплением (RL), а также человеческие оценки (RLHF). Но на фундаментальном уровне все эти сигналы работают в рамках одной и той же схеме числовой оптимизации. Независимо от того, называется ли сигнал «потерей» или «вознаграждением», он служит входом для алгоритма, который изменяет параметры модели так, чтобы лучше достигать заранее заданной цели. Система не переживает качественного перехода в состояние "удовлетворения" или мук совести за совершенную ошибку, после того как она обнаружена, как человек, она лишь становится эффективнее в оптимизации внешне заданной функции.