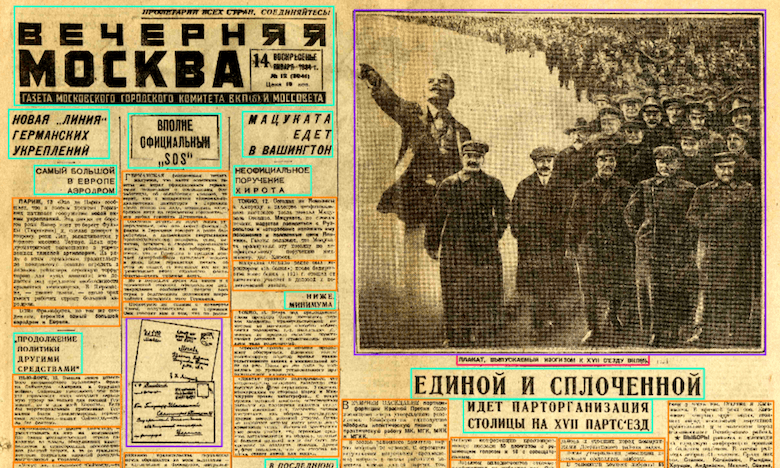
Попробуйте открыть скан советской газеты и прочитать одну статью от начала до конца. Человек быстро замечает крупный заголовок, продолжение в соседней колонке и подпись под фотографией. Для алгоритма перед ним — это выцветшая страница с дес...
Попробуйте открыть скан советской газеты и прочитать одну статью от начала до конца. Человек быстро замечает крупный заголовок, продолжение в соседней колонке и подпись под фотографией. Для алгоритма перед ним — это выцветшая страница с десятками тесно расположенных прямоугольников, нестандартными шрифтами и неоднозначным порядком чтения.
Даже если OCR правильно распознаёт почти все слова, на выходе ещё не получится документ. Нужно понять, какие фрагменты относятся к одной статье, где её начало, в каком порядке соединить блоки и что не следует включать в основной текст.
Мы разработали PereStruct — модульный пайплайн для разбора исторических газет. Он объединяет детектор вёрстки на базе YOLO, Yandex Vision OCR, коррекцию ошибок с помощью моделей Yandex AI Studio и отдельную модель семантической сборки статей. Вместе с кодом мы публикуем размеченный датасет и бенчмарк, чтобы другие команды могли изучать подход и ставить эксперименты на исторических документах.